Giải quyết những rào cản này là yêu cầu quan trọng để khơi thông nguồn dữ liệu, góp phần hiện thực hóa các mục tiêu của Chiến lược quốc gia về trí tuệ nhân tạo đến năm 2030, tầm nhìn đến năm 2045 (Chiến lược).
Chiến lược quốc gia về trí tuệ nhân tạo được Thủ tướng Chính phủ phê duyệt tại Quyết định số 1671/QĐ-TTg ngày 28/8/2026, đánh dấu bước chuyển từ tư duy nghiên cứu, phát triển và ứng dụng trí tuệ nhân tạo sang nghiên cứu, phát triển trí tuệ nhân tạo và chuyển đổi toàn diện quốc gia bằng trí tuệ nhân tạo. Trong cách tiếp cận mới, nhân lực, hạ tầng và dữ liệu được xác định là nền tảng. Riêng trụ cột về dữ liệu và mô hình trí tuệ nhân tạo đặt ra yêu cầu phát triển dữ liệu, hạ tầng dữ liệu và mô hình nhằm phục vụ nghiên cứu, phát triển, huấn luyện, kiểm thử, đánh giá và triển khai trí tuệ nhân tạo.
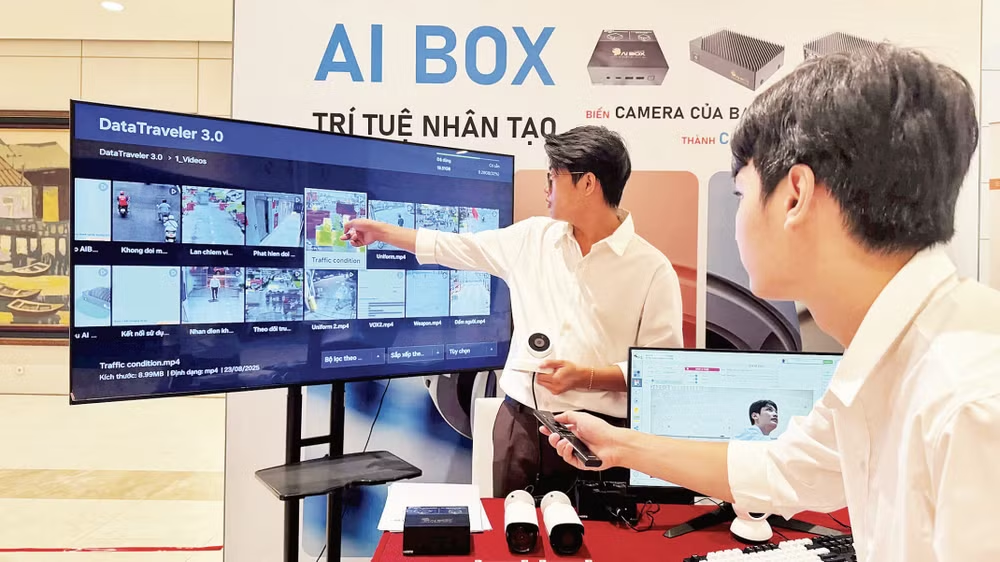
Giới thiệu các sản phẩm ứng dụng trí tuệ nhân tạo tại Ngày hội Trí tuệ nhân tạo Việt Nam năm 2025
Yêu cầu nêu trên được cụ thể hóa bằng hàng loạt nhiệm vụ như: phát triển, mở và chia sẻ các cơ sở dữ liệu quốc gia, cơ sở dữ liệu chuyên ngành, cơ sở dữ liệu dùng chung và các bộ dữ liệu lớn, chất lượng cao; phát triển hạ tầng và nền tảng chia sẻ dữ liệu, sản phẩm, dịch vụ và thị trường dữ liệu; hoàn thiện cơ chế mở, chia sẻ, lưu thông, truy cập an toàn và liên thông dữ liệu. Đáng chú ý, Chiến lược đặt ra nhiệm vụ hoàn thiện quy định về quyền tài sản đối với dữ liệu, sở hữu trí tuệ và khai thác hợp pháp nội dung phục vụ trí tuệ nhân tạo.
Các nhiệm vụ này có ý nghĩa trực tiếp đối với mục tiêu phát triển các mô hình trí tuệ nhân tạo tiếng Việt. Đến năm 2030, Chiến lược đặt mục tiêu phát triển ít nhất tám mô hình trí tuệ nhân tạo tiếng Việt ở các quy mô khác nhau, từ mô hình nhỏ phục vụ thiết bị biên và nhiệm vụ chuyên biệt đến các mô hình rất lớn định hướng giải quyết bài toán nền tảng cấp quốc gia và tham gia cạnh tranh ở quy mô khu vực, quốc tế.
Để xây dựng những mô hình như vậy, ngoài năng lực tính toán và đội ngũ chuyên gia, cần một lượng dữ liệu rất lớn, có chất lượng và đa dạng. Tuy nhiên, thực tế quá trình thu thập dữ liệu tự động từ internet và huấn luyện mô hình lại sao chép nhiều tác phẩm đang được bảo hộ quyền tác giả, bao gồm sách, báo, tranh ảnh, video và mã nguồn phần mềm. Bởi vậy, cùng với yêu cầu mở và khai thác dữ liệu, một vấn đề đặt ra là phải xác định phạm vi sử dụng hợp pháp các nội dung được bảo hộ để huấn luyện mô hình trí tuệ nhân tạo.
Theo Tiến sĩ Hoàng Minh Hiếu, Ủy viên là đại biểu chuyên trách tại Ủy ban Pháp luật và Tư pháp của Quốc hội, pháp luật hiện hành chưa thiết lập nghĩa vụ chủ động công khai thông tin về dữ liệu huấn luyện. Luật Trí tuệ nhân tạo nghiêm cấm việc thu thập, xử lý hoặc sử dụng dữ liệu để phát triển, huấn luyện, kiểm thử hoặc vận hành hệ thống trí tuệ nhân tạo trái với quy định của pháp luật về dữ liệu, bảo vệ dữ liệu cá nhân, sở hữu trí tuệ và an ninh mạng; đồng thời yêu cầu lưu giữ hồ sơ và cung cấp thông tin khi được yêu cầu. Các quy định này tạo cơ sở cho việc kiểm tra, xử lý nhưng chưa tạo cơ chế để chủ thể quyền biết tác phẩm của mình có sử dụng trong dữ liệu huấn luyện hay không.
Từ thực tiễn phát triển, Nền tảng AI Luật được Bộ Khoa học và Công nghệ khuyến nghị ưu tiên sử dụng để rà soát văn bản pháp luật, Thạc sĩ Trần Văn Trí, Giám đốc Công ty CP truyền thông Luật Việt Nam cho rằng, cần làm rõ phạm vi sử dụng dữ liệu để phát triển trí tuệ nhân tạo, nhất là phân biệt giữa dữ liệu có thể truy cập công khai với dữ liệu được phép sao chép, lưu trữ và sử dụng để huấn luyện. Nếu ranh giới này không được xác định rõ, quyền của tác giả, chủ sở hữu trong việc bảo lưu quyền tác giả, quyền liên quan cũng như nghĩa vụ trả tiền bản quyền của bên sử dụng dữ liệu để huấn luyện sẽ khó được thực thi.
Ông Trí dẫn chứng, nguồn dữ liệu đầu vào của Nền tảng AI Luật là các văn bản quy phạm pháp luật, văn bản hành chính thuộc nhóm đối tượng không nằm trong phạm vi bảo hộ quyền tác giả nhưng không có nghĩa mọi sản phẩm hình thành từ nguồn văn bản pháp luật đều được tự do sao chép, bởi quyền sở hữu trí tuệ có thể nằm ở phần mềm, hệ thống phân loại, liên kết hiệu lực, lịch sử thay đổi, chú thích điều khoản, nội dung biên tập chung quanh văn bản pháp luật đó.
Thực tế này cho thấy việc xác định nguồn gốc, tình trạng pháp lý và phạm vi được phép khai thác của dữ liệu là điều kiện quan trọng trước khi đưa dữ liệu vào huấn luyện trí tuệ nhân tạo. Do vậy, cần luật hóa nghĩa vụ minh bạch dữ liệu huấn luyện; nhà phát triển mô hình trí tuệ nhân tạo cần lưu giữ thông tin về nguồn dữ liệu, căn cứ và phạm vi sử dụng, và có cơ chế tiếp nhận, xử lý yêu cầu hợp pháp của chủ thể quyền.
Việc thiếu cơ chế minh bạch sẽ cản trở sự hình thành thị trường dữ liệu phục vụ trí tuệ nhân tạo, bởi các nhà phát triển trí tuệ nhân tạo sẽ không có động lực đàm phán mua quyền sử dụng nếu có thể khai thác miễn phí dưới danh nghĩa nghiên cứu, phát triển công nghệ. Đồng thời, kéo theo một rủi ro khác đó là kho dữ liệu số, báo chí, văn học và âm nhạc của Việt Nam có thể bị thu thập tự động để huấn luyện các mô hình đặt tại nước ngoài mà không đem lại nguồn thu nào cho tác giả và quốc gia.
Các chuyên gia cho rằng, cần bổ sung quy định gắn nghĩa vụ tuân thủ về dữ liệu huấn luyện với việc cung cấp sản phẩm, dịch vụ trí tuệ nhân tạo vào thị trường Việt Nam, không phụ thuộc vào nơi thực hiện hành vi huấn luyện. Việc hoàn thiện quy định theo hướng này sẽ giúp doanh nghiệp trong nước không bị bất lợi cạnh tranh, đồng thời là công cụ để bảo vệ tài nguyên dữ liệu quốc gia.
Trong bối cảnh các quy định về minh bạch dữ liệu huấn luyện trí tuệ nhân tạo chưa được cụ thể hóa, luật sư Lê Quang Vinh, Giám đốc Công ty sở hữu trí tuệ Bross và cộng sự khuyến cáo các doanh nghiệp cần chủ động quản trị rủi ro ngay từ nguồn dữ liệu đầu vào. Theo đó, cần xác định rõ dữ liệu được thu thập từ đâu và lưu giữ thông tin về quá trình khai thác để có cơ sở chứng minh khi phát sinh tranh chấp.
Bên cạnh việc hoàn thiện pháp luật, theo Tiến sĩ Hoàng Minh Hiếu, Quốc hội cần tiếp tục nâng cao hoạt động giám sát về việc triển khai các quy định chính sách pháp luật về nội dung này. Bên cạnh đó, Chính phủ phải báo cáo Quốc hội việc đánh giá tác động sau một thời gian thi hành với các chỉ tiêu định lượng cụ thể như số vụ tranh chấp phát sinh liên quan đến khai thác văn bản và dữ liệu đầu vào; số lượng tuyên bố bảo lưu quyền tác giả, quyền liên quan đã được đăng ký; số giao dịch cấp phép dữ liệu huấn luyện đã được thực hiện; chi phí tuân thủ bình quân của doanh nghiệp trí tuệ nhân tạo trong nước. Việc tháo gỡ những rào cản trong khai thác dữ liệu là điều kiện để hiện thực hóa các mục tiêu của Chiến lược quốc gia về trí tuệ nhân tạo. Khi quyền và nghĩa vụ của các bên được xác định rõ, dữ liệu mới có thể được chia sẻ, khai thác một cách an toàn, hợp pháp, qua đó tạo nguồn lực cho nghiên cứu, huấn luyện và phát triển các mô hình AI Việt Nam.